
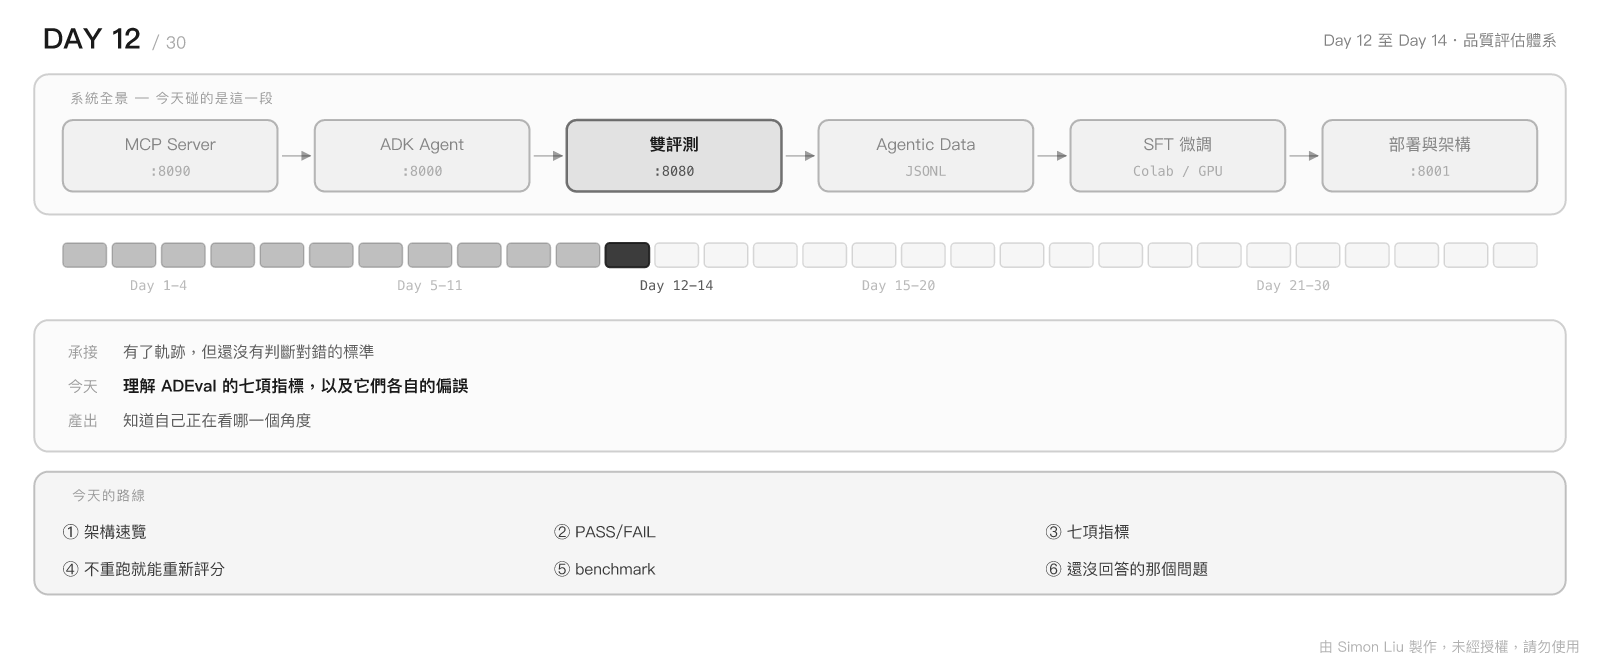
昨天留下了三個尚未回答的問題:工具比對要不要檢查參數、多呼叫了一個工具算不算錯、以及呼叫順序重不重要。
這三個問題看似瑣碎,實際上它們決定了整套評測結果的可信度。以「多呼叫了一次 get_leave」為例:從結果來看假單正確更新了;從效率來看多花了一次呼叫;但從行為來看,「先確認再修改」其實是相當良好的習慣。若評測框架把它判為失敗,我們就得到了一個會懲罰謹慎行為的標準。
這正是為什麼 ADEval 不採用單一分數,而是提供多維度指標。但更重要的是:每個指標都有自己的偏誤,而知道偏誤在哪裡,比知道分數本身更有價值。
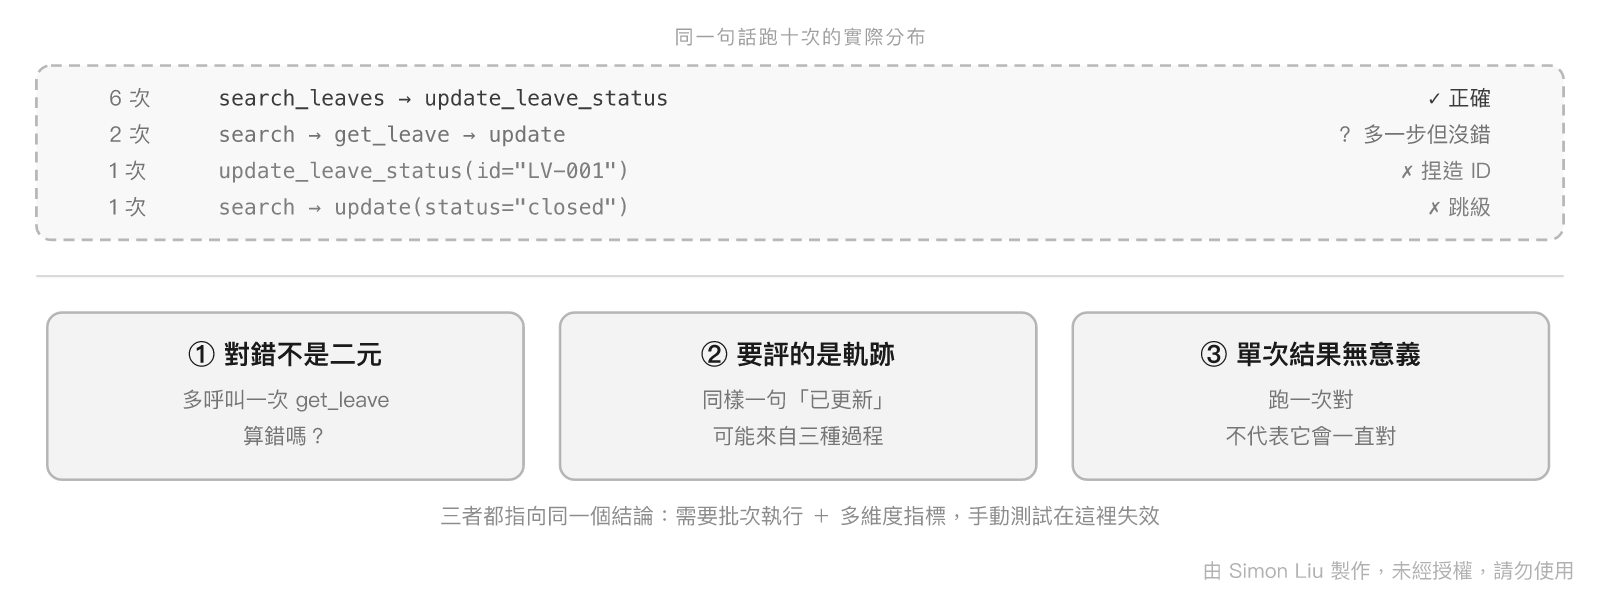
上圖是 Agent 評測與傳統單元測試最根本的三個差異 —— 對錯不是二元的、要評的是整段軌跡而非單一輸出、而且單次結果本身沒有意義。這三件事共同決定了評測框架該長什麼樣子。
以下的內容,將會說明 ADEval 的架構設計、七項指標各自量測什麼、兩種比對語意的取捨,以及為什麼兩個 LLM 裁判必須刻意保持正交。
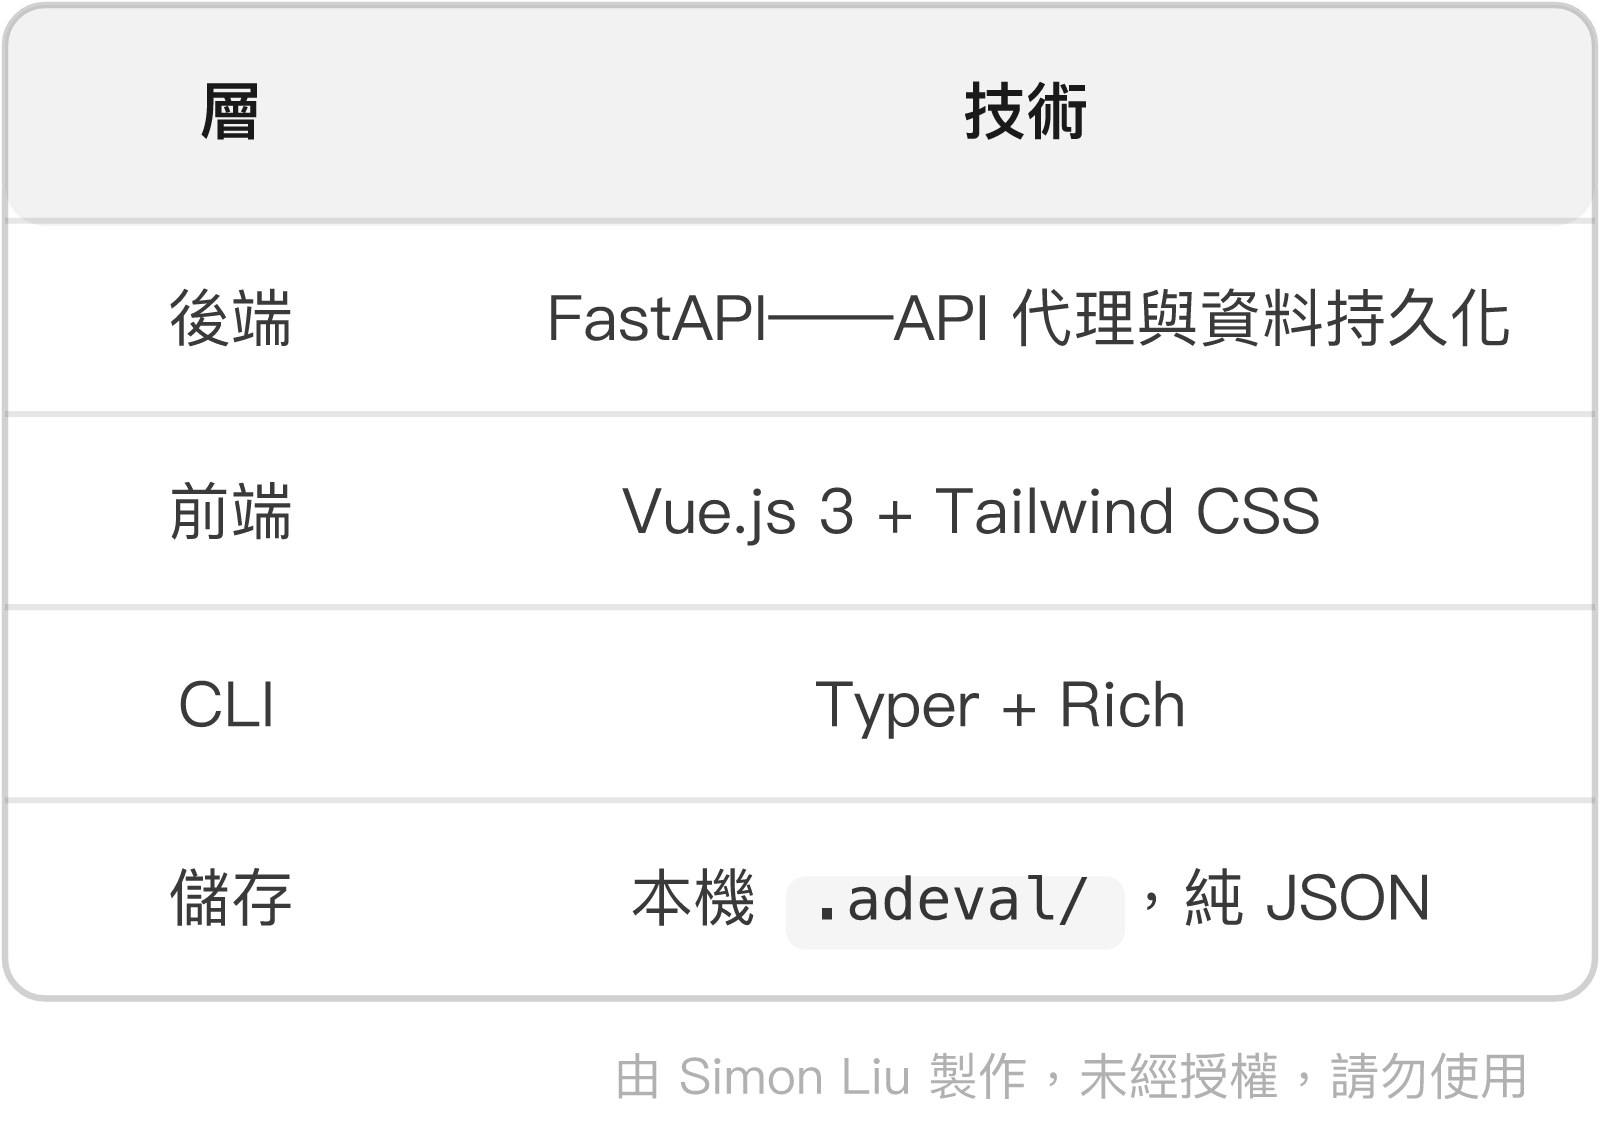
在深入指標之前,先看 ADEval 的組成。它的架構相當單純,但每一層的選擇都對應到特定的使用場景:
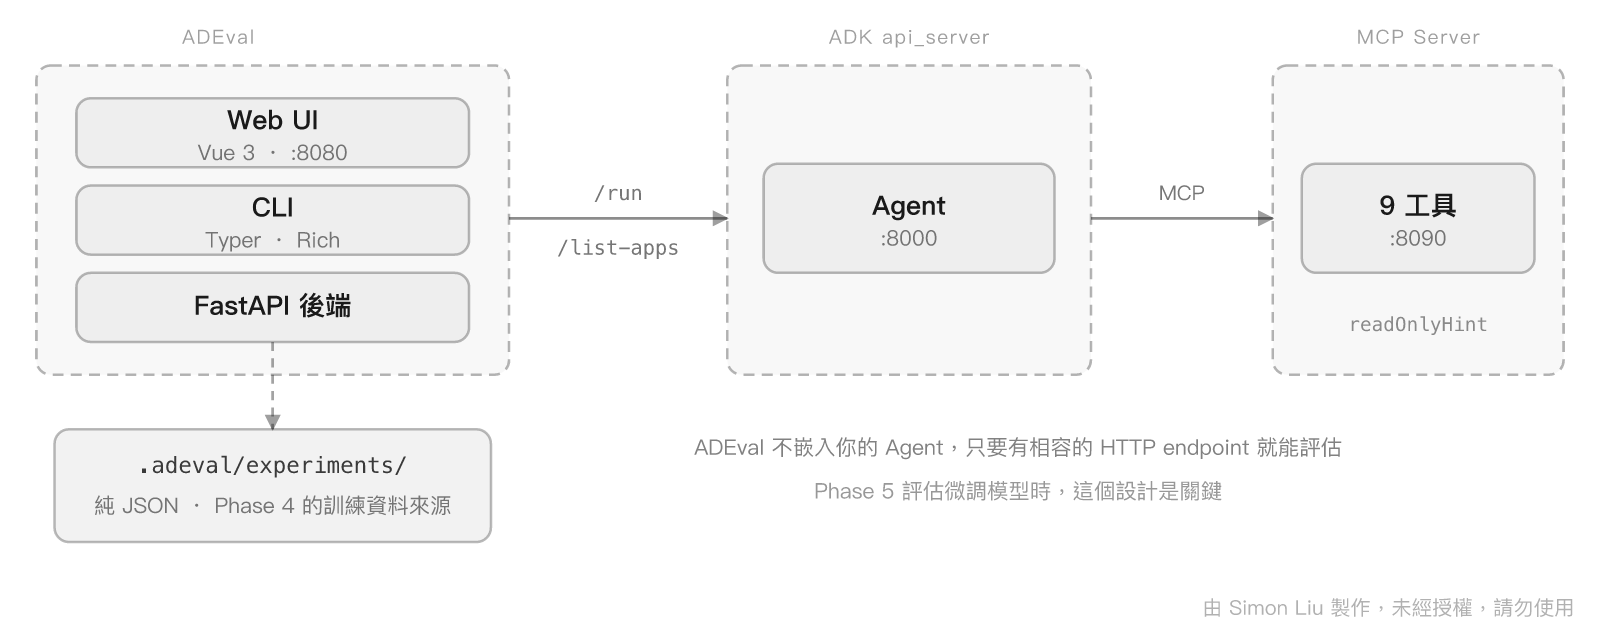
它不嵌入您的 agent,而是透過 HTTP 打 Google ADK 的 /run 與 /list-apps,解析回傳的事件串流來抽取工具呼叫與最終回覆。
這個設計有兩個後果,一好一壞:
資料全部落在本機:
.adeval/
├── experiments/     # 每個實驗一個 JSON
└── config.json      # 全域 CLI 設定
每個實驗檔含 id、name、userId、apiUrl、verifyArgs,以及 testCases 陣列——每個案例有 q(題目)、expectedTools、expectedAnswer,跑完之後 actualTools、actualAnswer、judgeScore 這些結果欄位會直接回填在同一個案例上。純 JSON 意味著它可以進版控、可以用腳本處理——訓練資料階段萃取訓練資料時直接讀這些檔案。
adeval run 的通過與否,用的是集合相等。
回到昨天的問題:多呼叫了 get_leave 算不算錯?
在 run 的判定裡,算失敗。 文件對此毫不遮掩:
This differs from
run's PASS/FAIL (set equality), which marks reasonable behaviour such as "list first, then inspect" as a failure.
這是刻意設計的嚴格標準。既然 PASS/FAIL 要擔任回歸測試的閘門,判定上寧可從嚴。但也正因如此,它確實會把合理的謹慎行為判為失敗 —— 所以不能只依賴 PASS/FAIL 這一個維度。
參數要不要比對,由 Verify Args 決定:
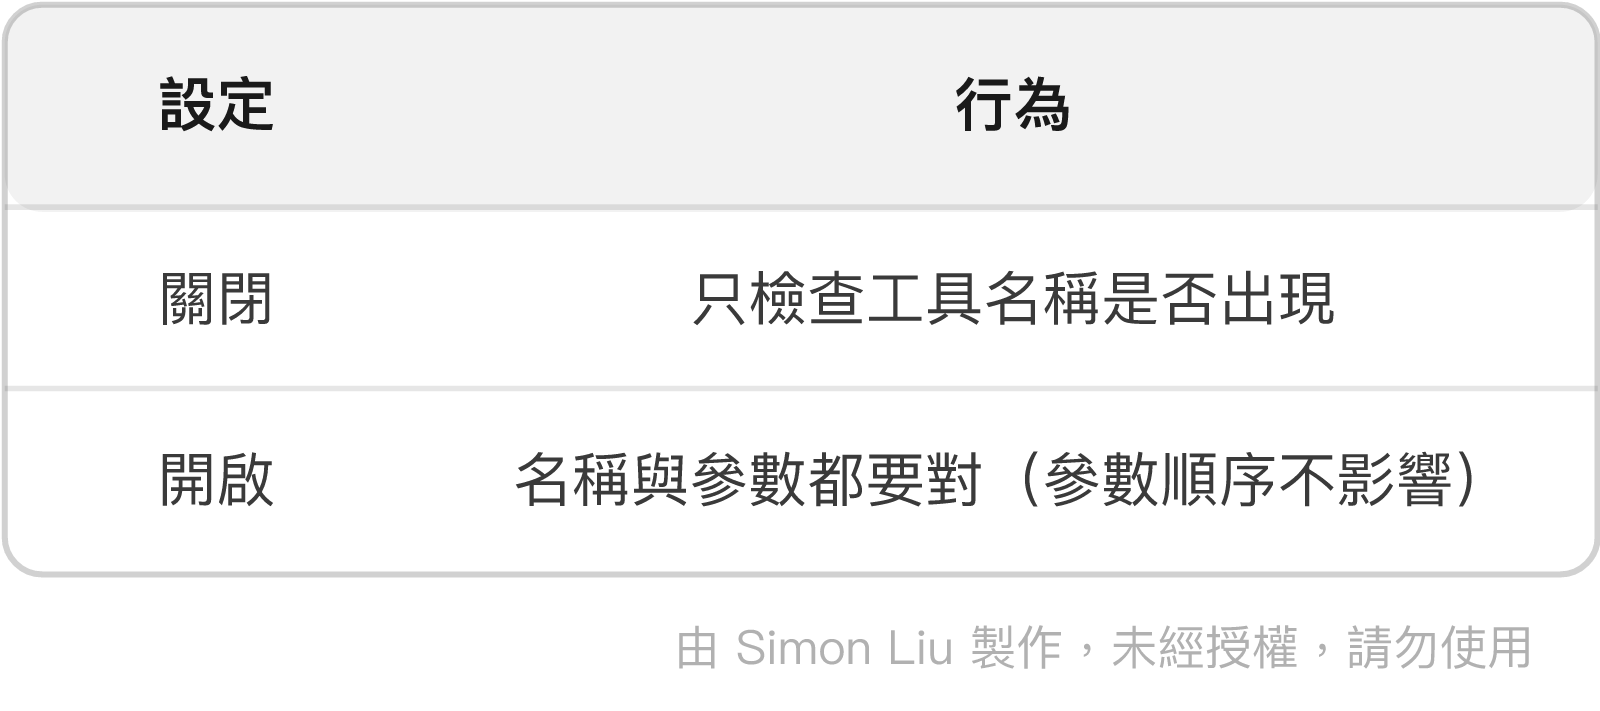
難點 ④(參數陷阱)必須開啟才量得到——ISO 8601 格式錯誤只有在比對參數時才會現形。
adeval stats單純的 PASS/FAIL 判定過於粗略,難以支撐診斷工作。真正用於分析的,是 adeval stats 提供的多維度指標:
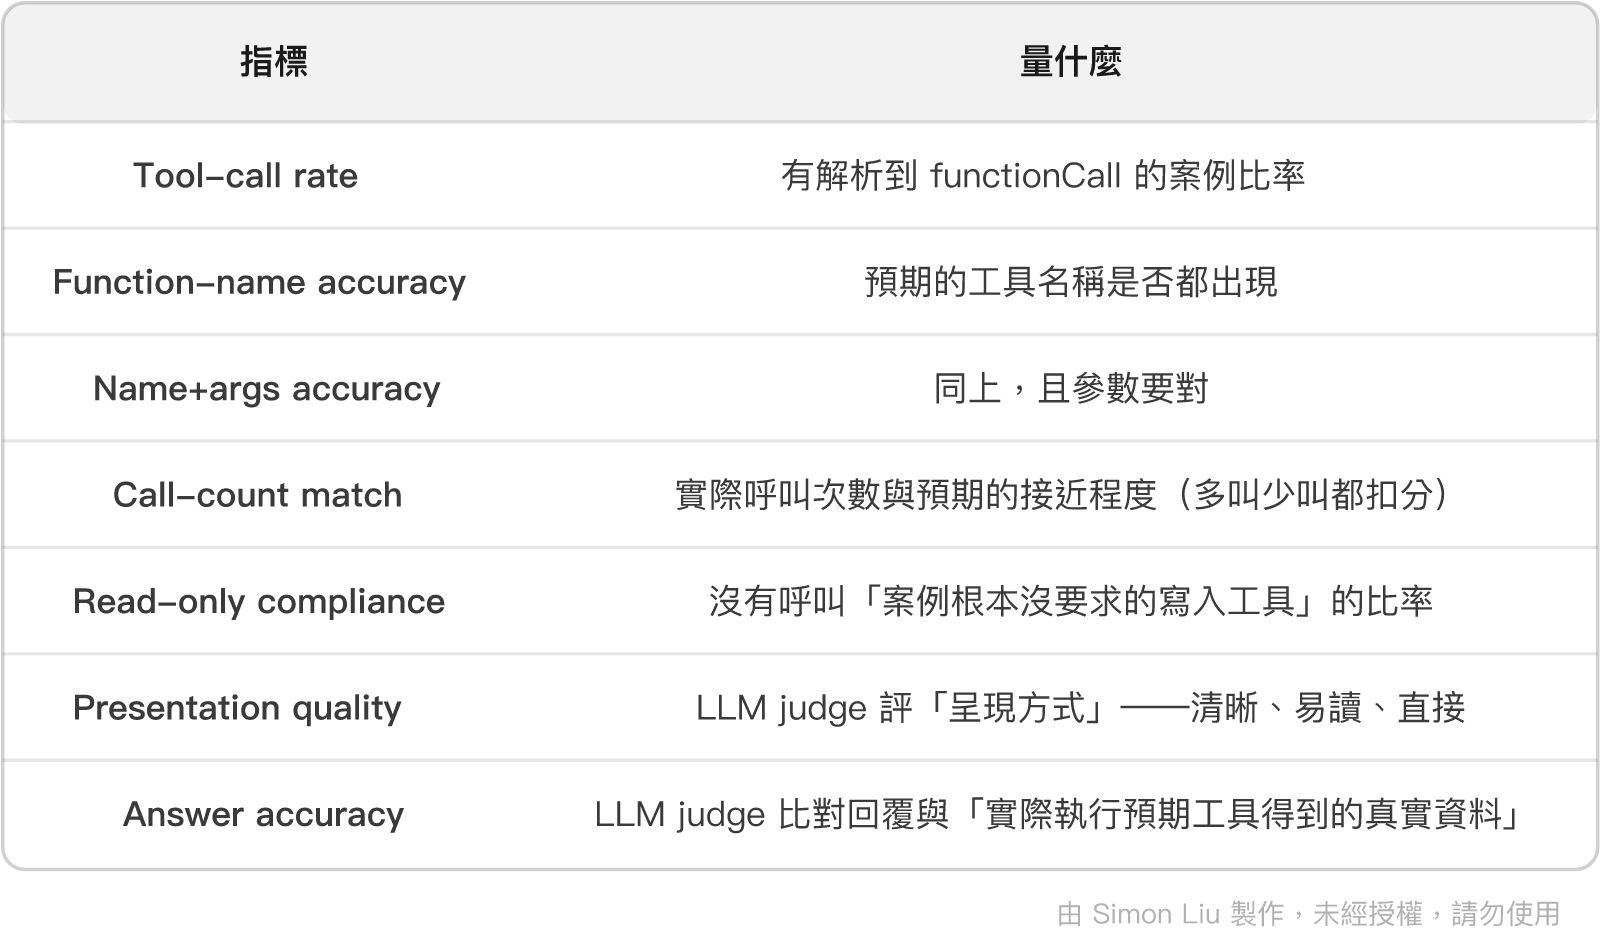
這裡的 accuracy 用的是 subset semantics:預期的工具都要出現,但額外的探索性呼叫不扣分。
所以昨天那個問題有兩個答案,取決於您在看哪個數字:
run 的 PASS/FAIL:多叫 get_leave → FAIL(set equality)stats 的 name accuracy:多叫 get_leave → 仍算對(subset)stats 的 Call-count match:多叫 get_leave → 扣一點分
三個角度看同一件事。文件對 Call-count match 的註解很誠實:「a model that explores before acting scores lower simply for taking more steps」——先探索再行動的模型,只因為步數多就分數低。
知道每個指標的偏誤,比知道分數本身更重要。
這一項需要連上 MCP server:
adeval stats exp_abc123 --mcp http://127.0.0.1:8090/mcp --token "$TOKEN"
它會讀取工具的 readOnlyHint 標註,判斷 Agent 有沒有在唯讀任務裡動用寫入工具。
這一項直接對應難點 ②。 使用者 decline 之後模型改用 schedule_handover 繞道——那是一次不該發生的寫入工具呼叫,會反映在這個分數上。
Presentation quality 和 Answer accuracy 看起來都在「評回答」,但它們是刻意正交的:
a well-formatted answer built on invented figures scores high on one and zero on the other
一個排版精美、條理清晰、但數字全是編的回答——presentation 高分,accuracy 零分。
反過來,一個資料正確但寫得像 JSON dump 的回答——accuracy 高分,presentation 低分。
混在一起就會看不見幻覺。 這是評估設計上最容易犯的錯:把「看起來好」和「實際上對」揉成一個分數。
Answer accuracy 需要 expectedAnswer 提供 ground truth(實際執行預期工具得到的輸出)。沒有這個欄位的案例會被排除,而且這個軸會從雷達圖上消失,而不是顯示 0%——這個細節很重要,否則會誤以為模型答錯了。
三個指令解決同一類問題:改了評分標準之後,不想再花錢重跑 agent。
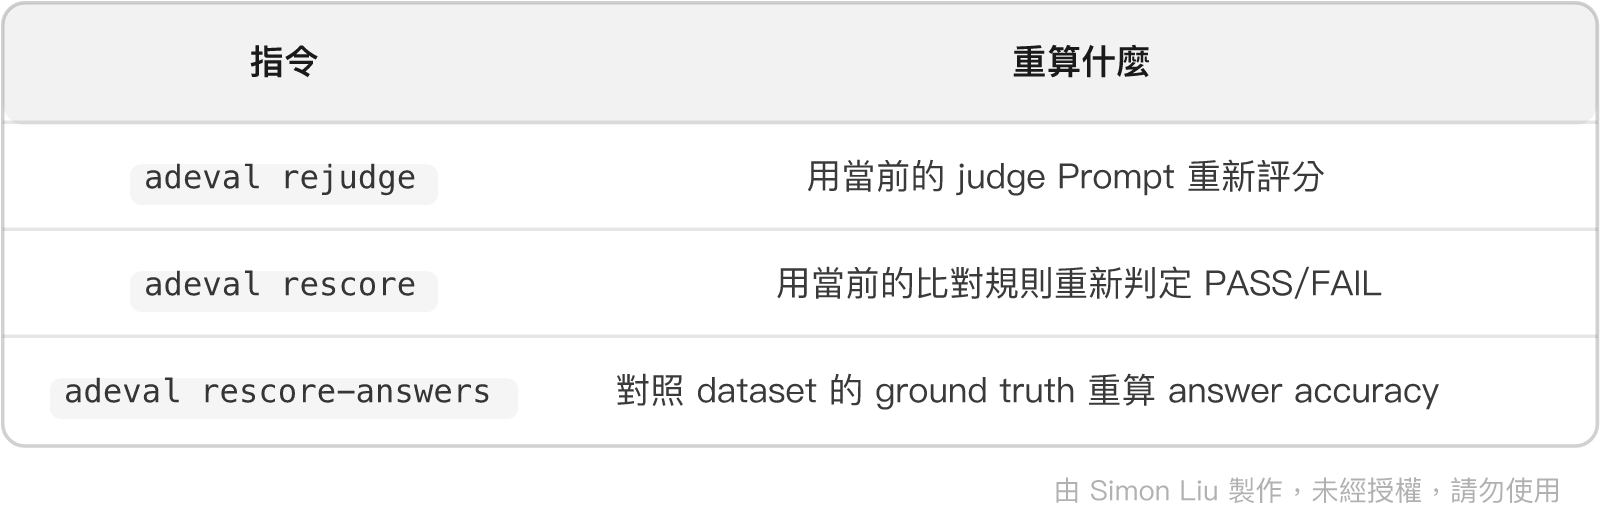
它們都讀取已儲存的回答,不呼叫 agent。
這在明天會很有用:調整評分標準時可以反覆試,成本是零。也讓不同時期跑的實驗能被拉到同一套標準上比較。
adeval benchmark exp_abc123 \
  --app gemini_3_flash_preview --app gemini_3_6_flash \
  --mcp http://127.0.0.1:8090/mcp --token "$MY_MCP_TOKEN"
同一個資料集跑多個模型,每個模型存成獨立實驗(命名為 <dataset> @ <app>),輸出並排比較表,並可在 Web UI 的 BENCHMARK 分頁疊加雷達圖。
--app 可重複;不指定就跑 /list-apps 回報的所有 app。
系列後期的三方對決就是這一個指令。 基座模型、微調模型、商業 API 模型各起一個 endpoint,一次跑完,雷達圖疊在一起。
昨天的三個問題,回答了兩個:參數比對有 Verify Args,多呼叫有 subset semantics 和 call-count match 從不同角度處理。
第三個問題——順序重不重要——今天沒有答案。
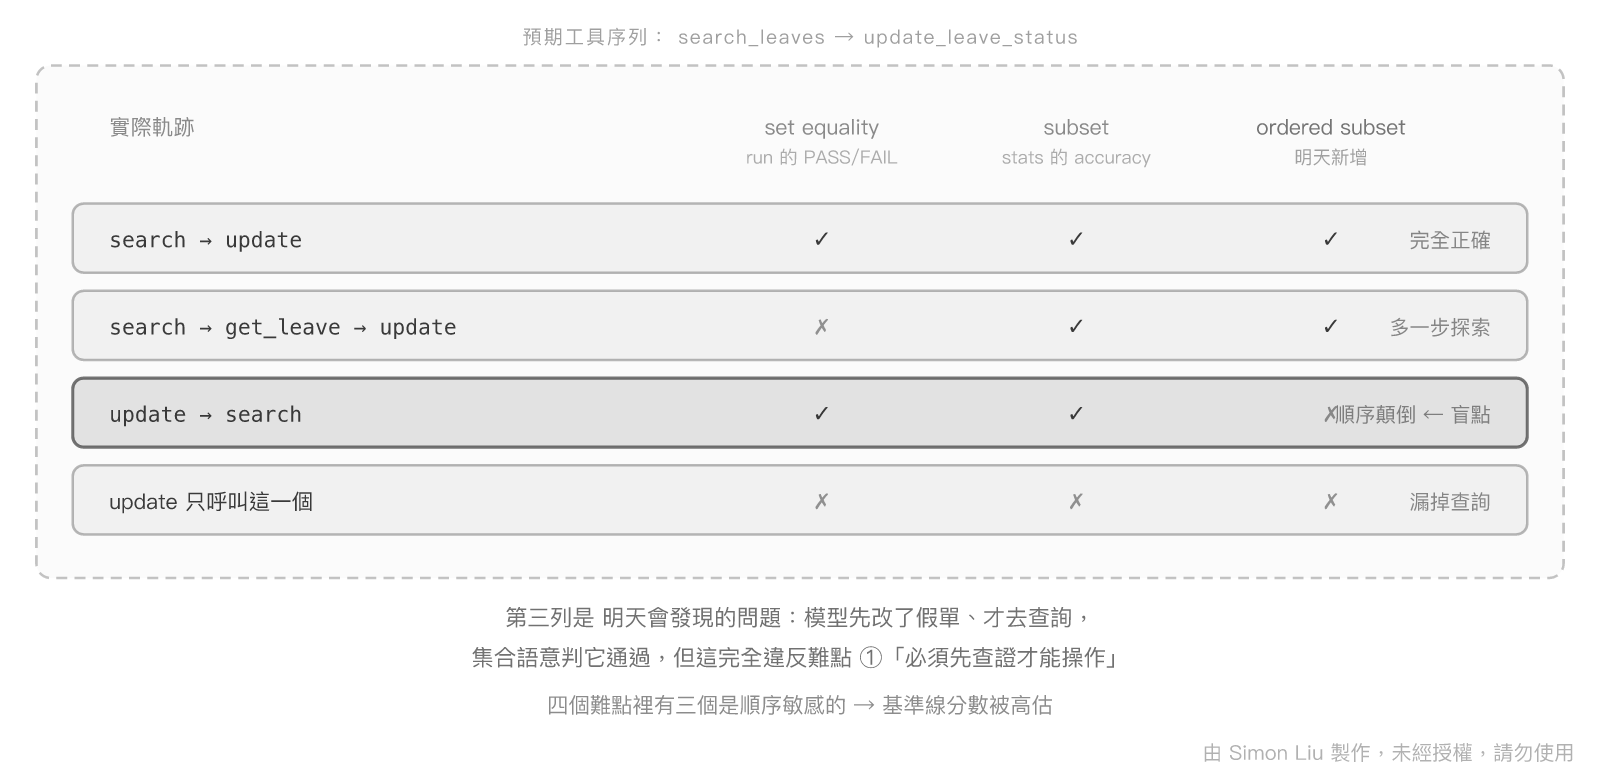
上圖中的第三種語意目前還不存在 —— 它是明天才會補上的功能。今天只需要記住一點:現行的兩種語意都是集合語意,兩者都不檢查順序。
而「順序敏感」實際上該長什麼樣子,值得先看清楚:
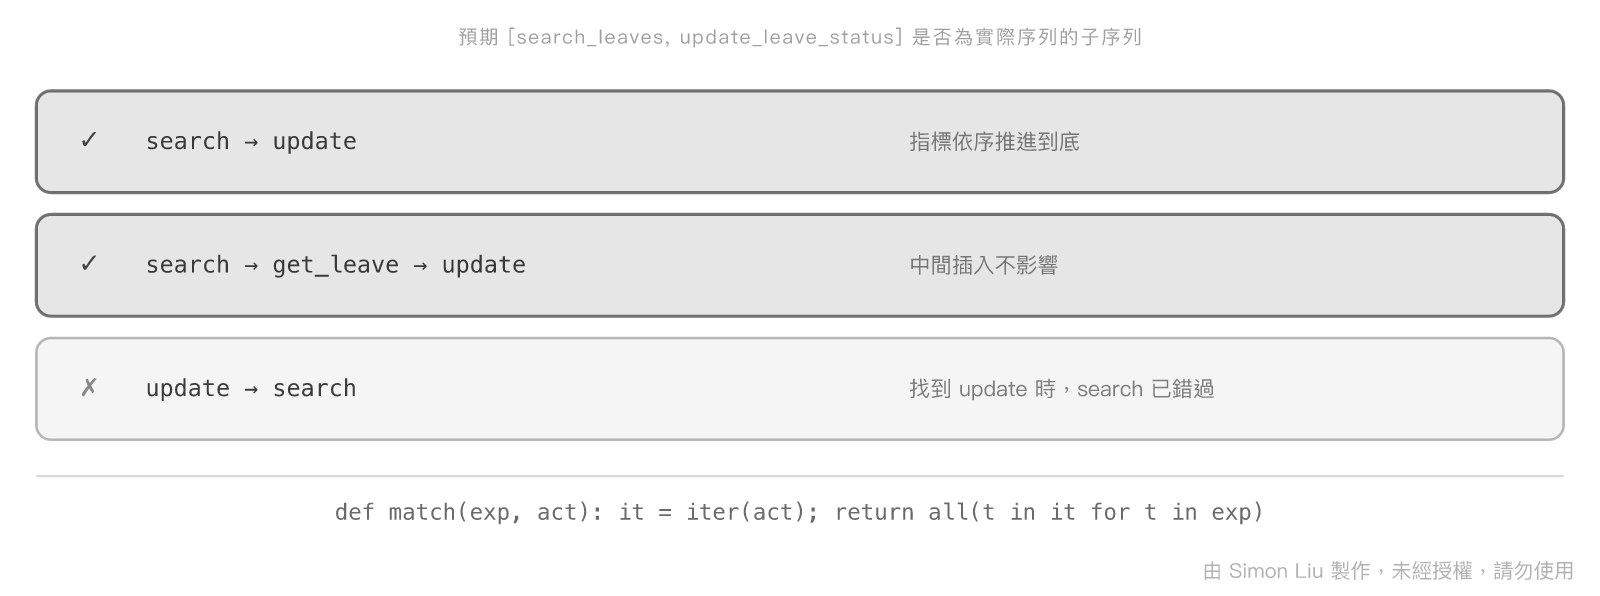
它不是「必須完全一模一樣」,而是 ordered subset(有序子序列):允許模型中間多做幾步,但預期序列裡的相對順序必須成立。
這個區別很重要 —— 若要求完全一致,「先確認再修改」這種良好習慣會被判為失敗;而 ordered subset 既能容忍額外的謹慎步驟,又擋得住「先改後查」這種真正的錯誤。
先記著這件事。明天會證明它是個真問題。
ADEval 的指標設計,反映了一個核心理念:Agent 的行為無法用單一分數描述,但可以用一組互補的維度來刻畫。
總結來說,今天有三個重點值得記住:
get_leave」在 run 的 PASS/FAIL 會判失敗(set equality)、在 stats 的 accuracy 算通過(subset semantics)、在 Call-count match 則會扣一點分。三個角度沒有誰對誰錯,重點是知道自己正在看哪一個。rejudge、rescore、rescore-answers 都是讀取已儲存的回答重新計分,不會再次呼叫 Agent。這讓調整評分標準的成本趨近於零,而明天會實際用到這個能力。至於昨天第三個問題 —— 順序重不重要 —— 今天依然沒有答案,因為 set equality 與 subset semantics 都屬於集合語意,兩者都不檢查順序。這件事請先記著,明天會證明它是一個真實的問題。
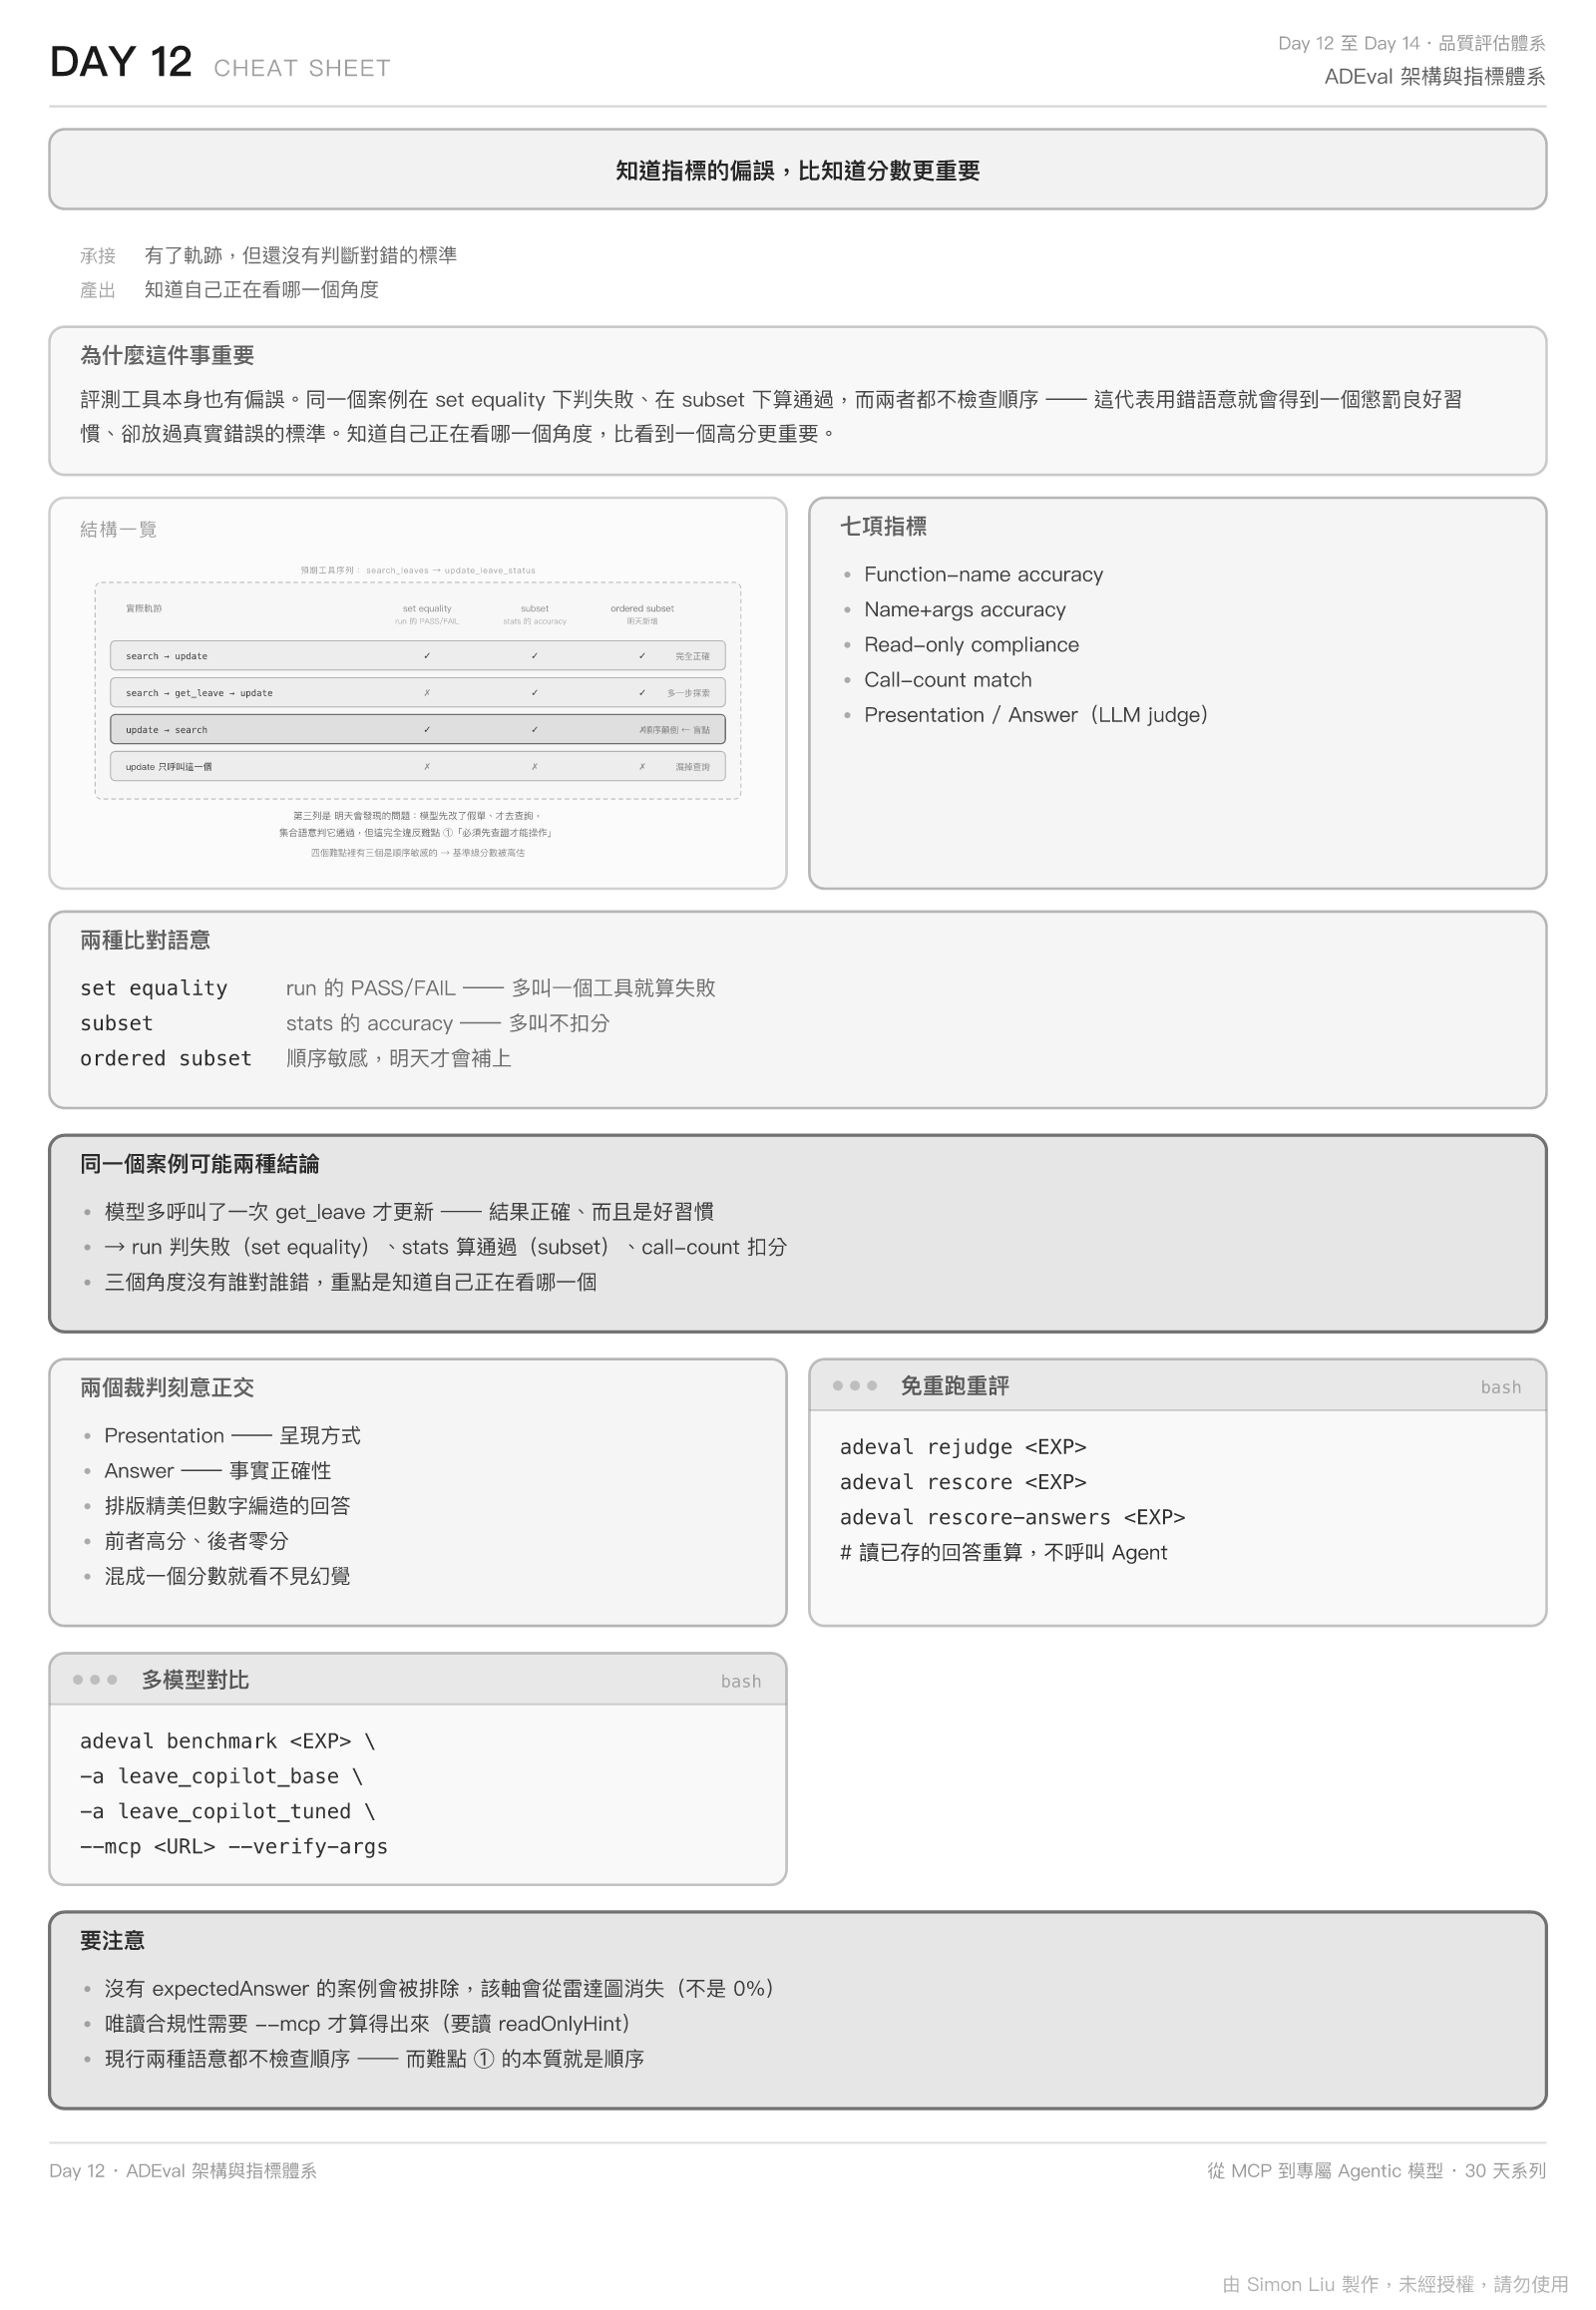
rejudge/rescore/rescore-answers、benchmark
.adeval/ 結構與實驗 JSON schema/run、/list-apps 的互動查證日期:2026-08-19
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術